
Xpath 是什么
Xpath:一种在 HTML/XML 文档中导航或定位元素的查询语言,让你能够准确地定位文档中的特定元素、属性或文本。
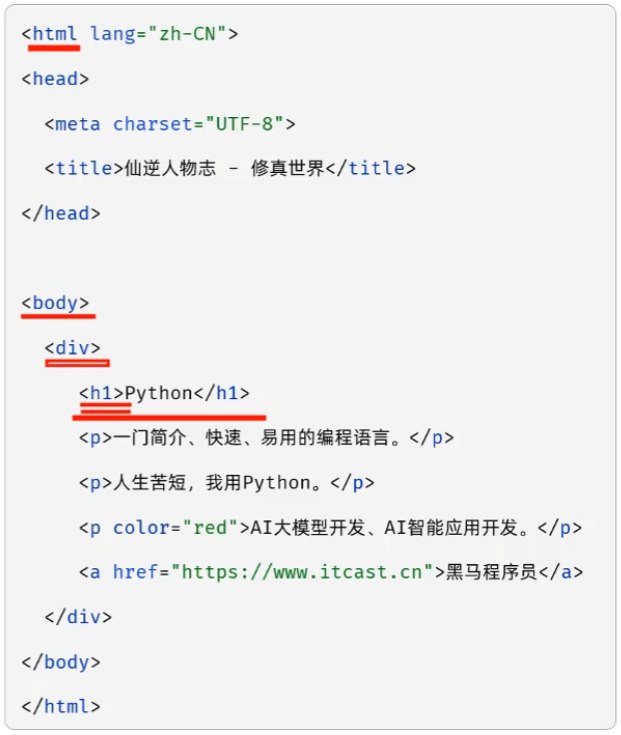
下面这份简化 HTML 是本篇所有表达式的练兵场:
<html>
<head><title>仙逆人物志 - 修真世界</title></head>
<body>
  <div>
    <h1>Python</h1>
    <p>一门简介、快速、易用的编程语言。</p>
    <p>人生苦短,我用Python。</p>
    <p color="red">AI大模型开发、AI智能应用开发。</p>
    <a href="https://www.itcast.cn">黑马程序员</a>
  </div>
</body>
</html>
常用表达式速查表
| 表达式 | 描述 | 样例 |
|---|---|---|
/ | 从根节点的直接子元素 | /html/body/div/h1 |
// | 从任意位置选择节点 | //h1 |
. | 当前节点下查找 | ./a 与 .//a |
[n] | 选择第 n 个元素 | //p[2] |
[last()] | 选择最后一个元素 | //p[last()] |
[@attr] | 选择有该属性的元素 | //p[@color] |
[@attr='value'] | 选择该属性值等于指定值的元素 | //p[@color='red'] |
* | 匹配任何元素节点 | //body/div/* |
@* | 匹配元素的任何属性 | //body/div/a/@* |
text() | 获取文本内容 | //div/p/text() |
 |
配合 lxml 使用
from lxml import html

with open("resources/仙逆人物志.html", "r", encoding="utf-8") as f:
    html_text = f.read()
    document = html.fromstring(html_text)

    th_list = document.xpath("//thead/tr/th/text()")          # // : 任意位置开始
    print(th_list)

    td_list = document.xpath("//tbody/tr[2]/td/text()")       # [2] : 第 2 个 tr
    print(td_list)

    td_list = document.xpath("//tbody/tr[last()-1]/td/text()")  # last()-1 : 倒数第 2 个
    print(td_list)

    p_list = document.xpath("//p[@class]/text()")             # 有 class 属性的 p
    print(p_list)

    p_list = document.xpath("//p[@class='xn']/text()")        # class 恰好等于 xn 的 p
    print(p_list)

    th_list = document.xpath("//thead/tr/*/text()")           # * : 任意标签
    print(th_list)

    a_list = document.xpath("//td/img/@*")                    # @* : 任意属性(如 src)
    print(a_list)
TIP
取属性值的写法是去掉 text()、直接写属性名://td/img/@src(取图片地址),//div/a/@href(取链接地址)。
相关
练习题
一、知识回顾(读完直接做下面的实践题)
- 从根节点的直接子元素开始找用
/;从任意位置选节点用//;在当前节点下查找用.;在当前节点下任意位置查找用.// - 路径写法:
//div/p/text()里的//表示从任意位置开始找,/p的/表示选直接子(下一层)元素,text()表示取元素里的文本内容;要取属性值就把text()换成@属性名 - 序号从 1 开始数;选第 2 个元素写成
[2];选最后一个写作[last()];选倒数第二个写作[last()-1] - 选择有该属性的元素写成
//p[@class];选择属性值等于指定值的写成//p[@class='xn'];取属性值本身的写法是@href(如取链接地址);属性值两边要用引号包起来 - 匹配任何元素节点用
*;匹配元素的任何属性用@*;//thead/tr/*/text()里的*代表任意(任何)标签;把它换成th,结果一样 - 配合 lxml:解析 HTML 字符串要调
html.fromstring()方法;文档对象调 XPath 的方法名是xpath();返回结果是列表;读文件时open()要写encoding="utf-8",否则中文会乱码 - 表格定位:表头那一行写成
//thead/tr/th/text();第 2 行数据写成//tbody/tr[2]/td/text();最后一行数据用[last()];//td是从任意位置找 td,而//table/td是从 table 的**直接子元素(下一层)**找 //div[2]/p[last()]/text():div[2]表示同级里的第 2 个div子元素;p[last()]表示这个 div 里的最后一个 p;text()表示取文本内容;要一次取到所有链接的地址,表达式是//a/@href
二、裸写题
练习素材是 练习库里的 resources/xpath_practice.html(练习目录 46-Xpath语法/,用 lxml 打开它跑一遍看结果):
- 提示(先自己想,实在想不出再点开)
一级 · 思路:先想"从哪儿找"(路径),再想"要元素本身,还是要它的文本" 二级 · 方法:定位用
//;取文本用text()三级 · 骨架://h1/____- 参考答案(做完再点开)
text//h1/text() # 也可写 /html/body/div[1]/h1/text()- 提示(先自己想,实在想不出再点开)
一级 · 思路:这一题要的不是文本,而是元素身上的属性值 二级 · 方法:取属性值直接在属性名前加
@三级 · 骨架://a/____- 参考答案(做完再点开)
text//a/@href- 提示(先自己想,实在想不出再点开)
一级 · 思路:先用方括号按"带什么条件"把元素筛出来,再取它的文本 二级 · 方法:带条件用
[@属性='值'];取文本用text()三级 · 骨架://a[@____='_blank']/____- 参考答案(做完再点开)
text//a[@target='_blank']/text()- 提示(先自己想,实在想不出再点开)
一级 · 思路:路径分两段:先定位"第几个 div",再定位这个 div 里"最后一个 p",最后取文本 二级 · 方法:第几个用
[n];最后一个用[last()];取文本用text()三级 · 骨架://div[____]/p[____]/____- 参考答案(做完再点开)
text//div[2]/p[last()]/text()
- 实跑验证(本机 Python 3.12 + lxml 6.1.3 跑 `resources/xpath_practice.html`,2026-09-23)
from lxml import html

with open("resources/xpath_practice.html", "r", encoding="utf-8") as f:
    document = html.fromstring(f.read())

for expr in ["//h1/text()", "//a/@href", "//a[@target='_blank']/text()", "//div[2]/p[last()]/text()"]:
print(expr, "->", document.xpath(expr))//h1/text() -> ['Xpath 练习页']
//a/@href -> ['https://www.itcast.cn', 'https://www.baidu.com']
//a[@target='_blank']/text() -> ['百度一下']
//div[2]/p[last()]/text() -> ['段落三:我是第二个 div 里最后一个 p,只有我能被末尾定位取到。']对照看:2-2 只出 2 个地址,是因为第 3 个 <a> 没有 href 属性;取文本用 text(),取属性值直接在属性名前加 @。
NOTE
- 页面
resources/xpath_practice.html是练习专用的:正文那份仙逆人物志.html里没有<a>、第二个 div 里也没有<p>,它的题目跑到最后会是空列表,练不了。 - 练习库
46-Xpath语法/里:test_01_basic.py↔ 2-1、test_05_links.py↔ 2-2、test_06_blank_target.py↔ 2-3、test_04_second_div_last_p.py↔ 2-4;另外test_02_last.py、test_03_attrs.py覆盖的是正文"配合 lxml 使用"里的倒数第二行、属性过滤与通配符那几个示例,可以当加练。