
字符串是 Python 中最常用的数据类型。我们可以使用引号( ' 或 " )来创建字符串。
创建字符串很简单,只要为变量分配一个值即可。例如:
var1 = 'Hello World!'
var2 = "Runoob"
Python 访问字符串中的值
Python 不支持单字符类型,单字符在 Python 中也是作为一个字符串使用。
Python 访问子字符串,可以使用方括号 [] 来截取字符串,字符串的截取的语法格式如下:
变量[头下标:尾下标]索引值以 0 为开始值, -1 为从末尾的开始位置。

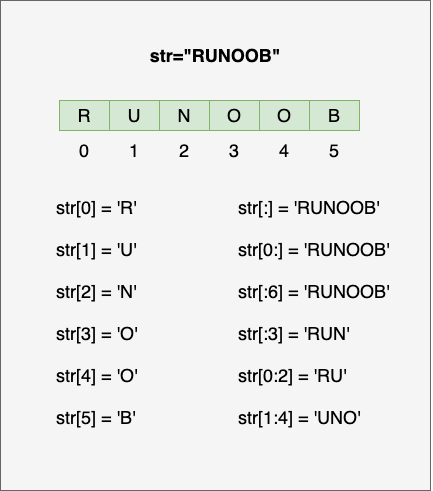
如下实例:
实例(Python 3.0+)
var1 = 'Hello World!'
var2 = "Runoob"

print("var1[0]: ", var1[0])
print("var2[1:5]: ", var2[1:5])
以上实例执行结果:
var1[0]:  H
var2[1:5]:  unoo
Python 字符串更新
你可以截取字符串的一部分并与其他字段拼接,如下实例:
实例(Python 3.0+)
var1 = 'Hello World!'
print("已更新字符串: ", var1[:6] + 'Runoob!')
以上实例执行结果
已更新字符串 : Hello Runoob!Python 转义字符
在需要在字符中使用特殊字符时,python 用反斜杠 \ 转义字符。如下表:
| 转义字符 | 描述 | 实例 |
|---|---|---|
| \(在行尾时) | 续行符 | >>> print("line1 \ ... line2 \ ... line3") line1 line2 line3 >>> |
| \\ | 反斜杠符号 | >>> print("\\") \ |
| \' | 单引号 | >>> print('\'') ' |
| \" | 双引号 | >>> print("\"") " |
| \a | 响铃 | >>> print("\a") 执行后电脑有响声。 |
| \b | 退格(Backspace) | >>> print("Hello \b World!") Hello World! |
| \000 | 空 | >>> print("\000") >>> |
| \n | 换行 | >>> print("\n") >>> |
| \v | 纵向制表符 | >>> print("Hello \v World!") Hello World! >>> |
| \t | 横向制表符 | >>> print("Hello \t World!") Hello World! >>> |
| \r | 回车,将 \r 后面的内容移到字符串开头,并逐一替换开头部分的字符,直至将 \r 后面的内容完全替换完成。 | >>> print("Hello\rWorld!") World! >>> print('google runoob taobao\r123456') 123456 runoob taobao |
| \f | 换页 | >>> print("Hello \f World!") Hello World! >>> |
| \yyy | 八进制数,y 代表 0~7 的字符,例如:\012 代表换行。 | >>> print("\110\145\154\154\157\40\127\157\162\154\144\41") Hello World! |
| \xyy | 十六进制数,以 \x 开头,y 代表的字符,例如:\x0a 代表换行 | >>> print("\x48\x65\x6c\x6c\x6f\x20\x57\x6f\x72\x6c\x64\x21") Hello World! |
| \other | 其它的字符以普通格式输出 |
使用 \r 实现百分比进度:
实例
import time

for i in range(101):
    # 添加进度条图形和百分比
    bar = '[' + '=' * (i // 2) + ' ' * (50 - i // 2) + ']'
    print(f"\r{bar} {i:3}%", end='', flush=True)
    time.sleep(0.05)
print()
以下实例,我们使用了不同的转义字符来演示单引号、换行符、制表符、退格符、换页符、ASCII、二进制、八进制数和十六进制数的效果:
实例
print('\'Hello, world!\'')  # 输出:'Hello, world!'

print("Hello, world!\nHow are you?")  # 输出:Hello, world!
# How are you?

print("Hello, world!\tHow are you?")  # 输出:Hello, world! How are you?

print("Hello,\b world!")  # 输出:Hello world!

print("Hello,\f world!")  # 输出:
# Hello,
# world!

print("A 对应的 ASCII 值为:", ord('A'))  # 输出:A 对应的 ASCII 值为: 65

print("\x41 为 A 的 ASCII 代码")  # 输出:A 为 A 的 ASCII 代码

decimal_number = 42
binary_number = bin(decimal_number)  # 十进制转换为二进制
print('转换为二进制:', binary_number)  # 转换为二进制: 0b101010

octal_number = oct(decimal_number)  # 十进制转换为八进制
print('转换为八进制:', octal_number)  # 转换为八进制: 0o52

hexadecimal_number = hex(decimal_number)  # 十进制转换为十六进制
print('转换为十六进制:', hexadecimal_number)  # 转换为十六进制: 0x2a
Python 字符串运算符
下表实例变量 a 值为字符串 "Hello",b 变量值为 "Python":
| 操作符 | 描述 | 实例 |
|---|---|---|
| + | 字符串连接 | a + b 输出结果: HelloPython |
| * | 重复输出字符串 | a*2 输出结果:HelloHello |
| [] | 通过索引获取字符串中字符 | a[1] 输出结果 e |
| [: ] | 截取字符串中的一部分,遵循 左闭右开 原则,str[0:2] 是不包含第 3 个字符的。 | a[1:4] 输出结果 ell |
| in | 成员运算符 - 如果字符串中包含给定的字符返回 True | 'H' in a 输出结果 True |
| not in | 成员运算符 - 如果字符串中不包含给定的字符返回 True | 'M' not in a 输出结果 True |
| r/R | 原始字符串 - 原始字符串:所有的字符串都是直接按照字面的意思来使用,没有转义特殊或不能打印的字符。 原始字符串除在字符串的第一个引号前加上字母 r(可以大小写)以外,与普通字符串有着几乎完全相同的语法。 | print( r'\n' ) print( R'\n' ) |
| % | 格式字符串 | 请看下一节内容。 |
实例(Python 3.0+)
a = "Hello"
b = "Python"

print("a + b 输出结果:", a + b)
print("a * 2 输出结果:", a * 2)
print("a[1] 输出结果:", a[1])
print("a[1:4] 输出结果:", a[1:4])

if ("H" in a):
    print("H 在变量 a 中")
else:
    print("H 不在变量 a 中")

if ("M" not in a):
    print("M 不在变量 a 中")
else:
    print("M 在变量 a 中")

print(r'\n')
print(R'\n')
以上实例输出结果为:
a + b 输出结果: HelloPython
a * 2 输出结果: HelloHello
a[1] 输出结果: e
a[1:4] 输出结果: ell
H 在变量 a 中
M 不在变量 a 中
\n
\n
Python 字符串格式化
Python 支持格式化字符串的输出 。尽管这样可能会用到非常复杂的表达式,但最基本的用法是将一个值插入到一个有字符串格式符 %s 的字符串中。
在 Python 中,字符串格式化使用与 C 中 sprintf 函数一样的语法。
实例(Python 3.0+)
print("我叫 %s 今年 %d 岁!" % ('小明', 10))以上实例输出结果:
我叫 小明 今年 10 岁!python字符串格式化符号:
| 符 号 | 描述 |
|---|---|
| %c | 格式化字符及其ASCII码 |
| %s | 格式化字符串 |
| %d | 格式化整数 |
| %u | 格式化无符号整型 |
| %o | 格式化无符号八进制数 |
| %x | 格式化无符号十六进制数 |
| %X | 格式化无符号十六进制数(大写) |
| %f | 格式化浮点数字,可指定小数点后的精度 |
| %e | 用科学计数法格式化浮点数 |
| %E | 作用同%e,用科学计数法格式化浮点数 |
| %g | %f和%e的简写 |
| %G | %f 和 %E 的简写 |
| %p | 用十六进制数格式化变量的地址 |
格式化操作符辅助指令:
| 符号 | 功能 |
|---|---|
| * | 定义宽度或者小数点精度 |
| - | 用做左对齐 |
| + | 在正数前面显示加号( + ) |
| <sp> | 在正数前面显示空格 |
| # | 在八进制数前面显示零('0'),在十六进制前面显示'0x'或者'0X'(取决于用的是'x'还是'X') |
| 0 | 显示的数字前面填充'0'而不是默认的空格 |
| % | '%%'输出一个单一的'%' |
| (var) | 映射变量(字典参数) |
| m.n. | m 是显示的最小总宽度,n 是小数点后的位数(如果可用的话) |
Python2.6 开始,新增了一种格式化字符串的函数 str.format() ,它增强了字符串格式化的功能。
Python三引号
python三引号允许一个字符串跨多行,字符串中可以包含换行符、制表符以及其他特殊字符。实例如下
实例(Python 3.0+)
para_str = """这是一个多行字符串的实例
多行字符串可以使用制表符 TAB ( \t )。
也可以使用换行符 [ \n ]。
"""
print(para_str)
以上实例执行结果为:
这是一个多行字符串的实例
多行字符串可以使用制表符 TAB (    )。
也可以使用换行符 [
 ]。
三引号让程序员从引号和特殊字符串的泥潭里面解脱出来,自始至终保持一小块字符串的格式是所谓的WYSIWYG(所见即所得)格式的。
一个典型的用例是,当你需要一块HTML或者SQL时,这时用字符串组合,特殊字符串转义将会非常的繁琐。
errHTML = '''
<HTML>
<HEAD>
<TITLE> Friends CGI Demo</TITLE>
</HEAD>
<BODY>
<H3>ERROR</H3>
<B>%s</B>
<P>
<FORM>
<INPUT TYPE=button VALUE=Back ONCLICK="window.history.back()">
</FORM>
</BODY>
</HTML>
'''

cursor.execute('''
CREATE TABLE users (
    login VARCHAR(8),
    uid INTEGER,
    prid INTEGER)
''')
f-string
f-string 是 python3.6 之后版本添加的,称之为字面量格式化字符串,是新的格式化字符串的语法。
之前我们习惯用百分号 (%):
实例
>>> name = 'Runoob'
>>> 'Hello %s' % name
'Hello Runoob'
f-string 格式化字符串以 f 开头,后面跟着字符串,字符串中的表达式用大括号 {} 包起来,它会将变量或表达式计算后的值替换进去,实例如下:
实例
>>> name = 'Runoob'
>>> f'Hello {name}'  # 替换变量
'Hello Runoob'
>>> f'{1+2}'  # 使用表达式
'3'

>>> w = {'name': 'Runoob', 'url': 'www.runoob.com'}
>>> f'{w["name"]}: {w["url"]}'
'Runoob: www.runoob.com'
用了这种方式明显更简单了,不用再去判断使用 %s,还是 %d。
在 Python 3.8 的版本中可以使用 = 符号来拼接运算表达式与结果:
实例
>>> x = 1
>>> print(f'{x+1}')  # Python 3.6
2

>>> x = 1
>>> print(f'{x+1=}')  # Python 3.8
x+1=2
Unicode 字符串
在Python2中,普通字符串是以8位ASCII码进行存储的,而Unicode字符串则存储为16位unicode字符串,这样能够表示更多的字符集。使用的语法是在字符串前面加上前缀 u 。
在Python3中,所有的字符串都是Unicode字符串。
Python 的字符串内建函数
Python 的字符串常用内建函数如下:
| 序号 | 方法及描述 |
|---|---|
| 1 | capitalize() 将字符串的第一个字符转换为大写 |
| 2 | center(width, fillchar) 返回一个指定的宽度 width 居中的字符串,fillchar 为填充的字符,默认为空格。 |
| 3 | count(str, beg= 0,end=len(string)) 返回 str 在 string 里面出现的次数,如果 beg 或者 end 指定则返回指定范围内 str 出现的次数 |
| 4 | bytes.decode(encoding="utf-8", errors="strict") Python3 中没有 decode 方法,但我们可以使用 bytes 对象的 decode() 方法来解码给定的 bytes 对象,这个 bytes 对象可以由 str.encode() 来编码返回。 |
| 5 | encode(encoding='UTF-8',errors='strict') 以 encoding 指定的编码格式编码字符串,如果出错默认报一个ValueError 的异常,除非 errors 指定的是'ignore'或者'replace' |
| 6 | endswith(suffix, beg=0, end=len(string)) 检查字符串是否以 suffix 结束,如果 beg 或者 end 指定则检查指定的范围内是否以 suffix 结束,如果是,返回 True,否则返回 False。 |
| 7 | expandtabs(tabsize=8) 把字符串 string 中的 tab 符号转为空格,tab 符号默认的空格数是 8 。 |
| 8 | find(str, beg=0, end=len(string)) 检测 str 是否包含在字符串中,如果指定范围 beg 和 end ,则检查是否包含在指定范围内,如果包含返回开始的索引值,否则返回-1 |
| 9 | index(str, beg=0, end=len(string)) 跟find()方法一样,只不过如果str不在字符串中会报一个异常。 |
| 10 | isalnum() 检查字符串是否由字母和数字组成,即字符串中的所有字符都是字母或数字。如果字符串至少有一个字符,并且所有字符都是字母或数字,则返回 True;否则返回 False。 |
| 11 | isalpha() 如果字符串至少有一个字符并且所有字符都是字母或中文字则返回 True, 否则返回 False |
| 12 | isdigit() 如果字符串只包含数字则返回 True 否则返回 False.. |
| 13 | islower() 如果字符串中包含至少一个区分大小写的字符,并且所有这些(区分大小写的)字符都是小写,则返回 True,否则返回 False |
| 14 | isnumeric() 如果字符串中只包含数字字符,则返回 True,否则返回 False |
| 15 | isspace() 如果字符串中只包含空白,则返回 True,否则返回 False. |
| 16 | istitle() 如果字符串是标题化的(见 title())则返回 True,否则返回 False |
| 17 | isupper() 如果字符串中包含至少一个区分大小写的字符,并且所有这些(区分大小写的)字符都是大写,则返回 True,否则返回 False |
| 18 | join(seq) 以指定字符串作为分隔符,将 seq 中所有的元素(的字符串表示)合并为一个新的字符串 |
| 19 | len(string) 返回字符串长度 |
| 20 | ljust(width[, fillchar]) 返回一个原字符串左对齐,并使用 fillchar 填充至长度 width 的新字符串,fillchar 默认为空格。 |
| 21 | lower() 转换字符串中所有大写字符为小写. |
| 22 | lstrip() 截掉字符串左边的空格或指定字符。 |
| 23 | maketrans() 创建字符映射的转换表,对于接受两个参数的最简单的调用方式,第一个参数是字符串,表示需要转换的字符,第二个参数也是字符串表示转换的目标。 |
| 24 | max(str) 返回字符串 str 中最大的字母。 |
| 25 | min(str) 返回字符串 str 中最小的字母。 |
| 26 | replace(old, new [, max]) 把 将字符串中的 old 替换成 new,如果 max 指定,则替换不超过 max 次。 |
| 27 | rfind(str, beg=0,end=len(string)) 类似于 find()函数,不过是从右边开始查找. |
| 28 | rindex( str, beg=0, end=len(string)) 类似于 index(),不过是从右边开始. |
| 29 | rjust(width,[, fillchar]) 返回一个原字符串右对齐,并使用fillchar(默认空格)填充至长度 width 的新字符串 |
| 30 | rstrip() 删除字符串末尾的空格或指定字符。 |
| 31 | split(str="", num=string.count(str)) 以 str 为分隔符截取字符串,如果 num 有指定值,则仅截取 num+1 个子字符串 |
| 32 | splitlines([keepends]) 按照行('\r', '\r\n', \n')分隔,返回一个包含各行作为元素的列表,如果参数 keepends 为 False,不包含换行符,如果为 True,则保留换行符。 |
| 33 | startswith(substr, beg=0,end=len(string)) 检查字符串是否是以指定子字符串 substr 开头,是则返回 True,否则返回 False。如果beg 和 end 指定值,则在指定范围内检查。 |
| 34 | strip([chars]) 在字符串上执行 lstrip()和 rstrip() |
| 35 | swapcase() 将字符串中大写转换为小写,小写转换为大写 |
| 36 | title() 返回"标题化"的字符串,就是说所有单词都是以大写开始,其余字母均为小写(见 istitle()) |
| 37 | translate(table, deletechars="") 根据 table 给出的表(包含 256 个字符)转换 string 的字符, 要过滤掉的字符放到 deletechars 参数中 |
| 38 | upper() 转换字符串中的小写字母为大写 |
| 39 | zfill (width) 返回长度为 width 的字符串,原字符串右对齐,前面填充0 |
| 40 | isdecimal() 检查字符串是否只包含十进制字符,如果是返回 true,否则返回 false。 |
相关
练习题
一、知识回顾(读完直接做下面的实践题)
- 创建字符串:用单引号
'...'或双引号"..."都行,两者完全等价;Python 没有单独的字符类型,单个字符也算字符串 - 访问字符:方括号里写下标,
s[0]是第一个、s[-1]是最后一个;切片写变量[头下标:尾下标],含头不含尾(s[0:5]取索引 0~4 共 5 个字符) - 字符串运算符:
+连接、*重复、[]按索引取、[:]切片、in/not in判断子串在不在里面;引号前加r就是原始字符串(\不再转义) - 字符串不可变:不能按下标改字符;想"更新"只能截出一部分再拼出新字符串(如
s[:6] + 'Runoob!') - 转义字符:
\n换行、\t横向制表符、\\反斜杠本身、\'和\"引号、\r回车(可以拿来做原地刷新的进度条)、\b退格、\f换页;\000是八进制、\xhh是十六进制 - 格式化的老写法用
%:%s字符串、%d整数、%f浮点数、%x十六进制等,写成print("我叫 %s 今年 %d 岁!" % ('小明', 10)) - f-string:引号前加
f,{}里可以直接写变量或表达式(f'Hello {name}'、f'{1+2}');{}里用到引号时,外层与内层要错开(外层单引号、内层双引号);Python 3.8 起写{x+1=}还能把"表达式=结果"一起输出 - 三引号
"""..."""可以跨多行,里面的换行、制表符原样保留(所见即所得),常用来塞 HTML、SQL 这类长文本 - 大小写与空白:
upper()全大写、lower()全小写、title()每个单词首字母大写、swapcase()大小写互换;strip()去掉两边空白、lstrip()去左边、rstrip()去右边 - 查找、替换与切分:
find(子串)返回位置(找不到返回 -1)、index(子串)类似但找不到会报错、startswith()/endswith()判断开头结尾、isalpha()等一批is开头的方法做判断;replace(旧, 新)替换、count(子串)统计次数;split(分隔符)切成列表、splitlines()按行切、分隔符.join(列表)合并回字符串
二、裸写题
- 创建字符串
s = "Hello Python" - 打印第一个字符、最后一个字符
- 打印索引 0 到 5 的切片
- 打印字符串重复 3 次的结果
- 提示(先自己想,实在想不出再点开)
一级 · 思路:索引从左往右从 0 开始、从右往左从 -1 开始;切片"含头不含尾";重复用乘号 二级 · 方法:
s[0]取第一个(也可写s[-1]取最后一个)、s[开始:结束]切片、s * 次数重复 三级 · 骨架:print(f"第一个字符: {s[____]}")/print(f"最后一个字符: {s[-____]}")/print(f"切片 [0:5]: {s[0:____]}")/print(f"重复3次: {s ____ 3}")- 参考答案(做完再点开)
python# 2-1 s = "Hello Python" print(f"第一个字符: {s[0]}") # H print(f"最后一个字符: {s[-1]}") # n print(f"切片 [0:5]: {s[0:5]}") # Hello print(f"重复3次: {s * 3}")- 创建字符串
- 用
+拼接字符串"Hello"和"World" - 用
%格式化:"我叫%s,今年%d岁"(张三,20) - 用 f-string 格式化同样的内容
- 提示(先自己想,实在想不出再点开)
一级 · 思路:连接两个字符串用一个加号;按模板填空有两种路数——老式的百分号占位,和新式的引号前缀写法 二级 · 方法:拼接
str1 + str2;%格式化写"我叫%s,今年%d岁" % (name, age);f-string 写f"我叫{name},今年{age}岁"三级 · 骨架:print("Hello" + " " + "____")/print("我叫%s,今年%d岁" % ("张三", ____))/print(f"我叫{____},今年{____}岁")- 参考答案(做完再点开)
python# 2-2 # 拼接 print("Hello" + " " + "World") # Hello World # % 格式化 print("我叫%s,今年%d岁" % ("张三", 20)) # f-string 格式化 name = "张三" age = 20 print(f"我叫{name},今年{age}岁")- 用
- 将
"hello world"转换为大写 - 统计
"hello world"中l出现的次数 - 将
"hello world"中的world替换为Python - 去掉
" hello "两边的空格
- 提示(先自己想,实在想不出再点开)
一级 · 思路:四件事各对应一个方法:转大写、数 l 出现几次、把 world 换成 Python、去掉字符串两边的空格 二级 · 方法:转大写
s.upper();统计次数s.count(字符);替换s.replace(旧, 新);去空格s.strip()(两边)、s.lstrip()(左边)、s.rstrip()(右边) 三级 · 骨架:print(f"大写: {s.____()}")/print(f"l出现次数: {s.____('l')}")/print(f"替换: {s.____('world', 'Python')}")/print(f"去空格: {' hello '.____()}")- 参考答案(做完再点开)
python# 2-3 s = "hello world" print(f"大写: {s.upper()}") # HELLO WORLD print(f"l出现次数: {s.count('l')}") # 3 print(f"替换: {s.replace('world', 'Python')}") # hello Python print(f"去空格: {' hello '.strip()}") # hello- 将
- 查找
"hello world"中world的位置 - 判断字符串是否以
hello开头 - 判断字符串是否以
world结尾 - 判断字符串是否只包含字母
批改(2026-09-28):✅ 正确(
s.find("world")得 6,startswith、endswith、isalpha 三项都输出 True)。- 提示(先自己想,实在想不出再点开)
一级 · 思路:查位置和三种判断各对应一个方法;注意查位置用的是"找不到也不报错"的那一个 二级 · 方法:查找位置
s.find(子串)(找不到返回 -1);判断开头s.startswith(子串);判断结尾s.endswith(子串);判断是不是纯字母s.isalpha()三级 · 骨架:print(f"world的位置: {s.____('world')}")/print(f"是否以hello开头: {s.____('hello')}")/print(f"是否只包含字母: {'hello'.____()}")- 参考答案(做完再点开)
python# 2-4 s = "hello world" print(f"world的位置: {s.find('world')}") # 6 print(f"是否以hello开头: {s.startswith('hello')}") # True print(f"是否以world结尾: {s.endswith('world')}") # True print(f"是否只包含字母: {'hello'.isalpha()}") # True- 查找
- 将
"a,b,c,d"按逗号分割成列表 - 将列表
["Hello", "World"]用空格合并成字符串 - 将多行字符串按行分割
批改(2026-09-28):⚠️ 分割和多行分割都对(
['a', 'b', 'c', 'd']、['第一行', '第二行', '第三行'],多行字符串没有把缩进带进输出);合并时写的是小写["hello", "world"],输出hello world,题面是["Hello", "World"](应输出Hello World)。- 提示(先自己想,实在想不出再点开)
一级 · 思路:分割是"把一整串按某个符号拆成一堆",合并正好反过来"用某个符号把一堆接成一串";按行拆分有单独的方法 二级 · 方法:分割
s.split(分隔符)返回列表;合并分隔符.join(列表);按行分割s.splitlines()三级 · 骨架:print(f"分割: {s.____(',')}")/print(f"合并: {' '.____(lst)}")/print(f"按行分割: {text.____()}")- 参考答案(做完再点开)
python# 2-5 # 分割 s = "a,b,c,d" print(f"分割: {s.split(',')}") # ['a', 'b', 'c', 'd'] # 合并 lst = ["Hello", "World"] print(f"合并: {' '.join(lst)}") # Hello World # 多行分割 text = """第一行 第二行 第三行""" print(f"按行分割: {text.splitlines()}")- 将
- 打印包含换行符的字符串
- 打印包含制表符的字符串
- 打印包含反斜杠的字符串(用原始字符串 r'')
- 打印单引号和双引号
批改(2026-09-28):✅ 正确(换行
第一行/第二行、制表符制表→符、原始字符串你好\你好、单引号和双引号都打印出来了,四种情况齐全)。- 提示(先自己想,实在想不出再点开)
一级 · 思路:换行、制表符都是在字符串里写"反斜杠 + 字母";想让反斜杠保持原样不被转义,就在引号前加一个字母前缀;引号嵌套时外层用一种、内层换另一种 二级 · 方法:换行符
\n、制表符\t;原始字符串r'C:\new\test'(不转义);引号可以写'他说:"你好!"'或"他说:'你好!'"三级 · 骨架:print("第一行____第二行")/print("姓名____年龄\t城市")/print(____'C:\new\test')/print('他说:"____!"')- 参考答案(做完再点开)
python# 2-6 # 换行符 print("第一行\n第二行") # 制表符 print("姓名\t年龄\t城市") print("张三\t20\t北京") # 原始字符串 print(r'C:\new\test') # 单引号和双引号 print('他说:"你好!"') print("他说:'你好!'")